Crawl Budget: Definisi, Cara Optimasi, dan Pentingnya bagi SEO
Google tidak selalu langsung menemukan dan meng-crawl setiap halaman yang ada di sebuah website. Pada website dengan ribuan hingga jutaan URL, proses ini membutuhkan pengelolaan yang baik agar Googlebot dapat menemukan halaman penting secara efisien.
Salah satu aspek teknis SEO yang berkaitan dengan proses tersebut adalah crawl budget. Istilah ini mengacu pada jumlah URL yang dapat dan ingin di-crawl oleh Google dalam periode tertentu.
Memahami crawl budget membantu kamu mengelola struktur website, mengurangi URL yang tidak diperlukan, dan memastikan halaman penting lebih mudah ditemukan oleh Googlebot. Berikut penjelasan mengenai cara kerja, faktor yang memengaruhi, serta strategi optimasinya.
Apa Itu Crawl Budget?
Crawl budget adalah jumlah URL yang dapat dan ingin di-crawl oleh Googlebot pada sebuah website dalam periode tertentu.
Istilah budget dalam konteks ini bukan berarti biaya, melainkan alokasi resource crawling yang digunakan Google untuk mengunjungi URL di sebuah website.
Misalnya, sebuah website memiliki 10.000 URL. Googlebot tidak harus mengunjungi seluruh URL tersebut setiap kali melakukan crawling. Google akan menentukan URL mana yang perlu di-crawl berdasarkan kapasitas server dan kebutuhan untuk memperbarui informasi dalam indeksnya.
Perlu dipahami bahwa crawling dan indexing merupakan dua proses berbeda. Crawling adalah proses ketika Googlebot mengunjungi dan membaca halaman, sedangkan indexing merupakan proses evaluasi dan penyimpanan informasi halaman agar berpotensi muncul di hasil pencarian.
Artinya, halaman yang sudah di-crawl belum tentu akan diindeks oleh Google. Begitu pula, mengoptimalkan crawl budget tidak menjamin semua halaman mendapatkan peringkat di SERP.
Mengapa Crawl Budget Penting untuk SEO?
Crawl budget membantu Googlebot menggunakan resource crawling secara lebih efisien. Hal ini terutama penting bagi website dengan jumlah halaman besar atau konten yang sering diperbarui.
Berikut beberapa alasan mengapa pengelola website perlu memperhatikannya.
1. Membantu Google Menemukan Halaman Penting
Website dengan banyak URL berpotensi memiliki halaman yang kurang penting, seperti halaman filter, parameter URL, atau versi duplikat.
Jika Googlebot terlalu sering mengunjungi URL tersebut, proses crawling pada halaman penting bisa menjadi kurang efisien. Pengelolaan URL membantu Google lebih mudah menemukan konten yang memang ingin kamu tampilkan di hasil pencarian.
2. Mempercepat Penemuan Konten Baru dan Update
Ketika kamu menerbitkan artikel atau memperbarui halaman produk, Google perlu menemukan perubahan tersebut melalui proses crawling.
Struktur website yang rapi, internal linking yang relevan, dan sitemap yang diperbarui dapat membantu Google menemukan URL baru maupun perubahan pada halaman yang sudah ada.
Namun, crawling yang lebih cepat tidak otomatis membuat halaman langsung terindeks atau mendapatkan peringkat lebih tinggi.
3. Mengurangi Crawling pada URL yang Tidak Diperlukan
Beberapa website menghasilkan banyak URL dengan konten serupa akibat filter, sorting, parameter tracking, atau session ID.
Jika tidak dikelola, URL tersebut dapat membuat Googlebot menghabiskan resource untuk mengunjungi halaman yang tidak memberikan nilai tambahan.
Karena itu, pengelolaan URL menjadi salah satu bagian penting dalam optimasi crawl budget.
Bagaimana Crawl Budget Bekerja?
Google menentukan crawl budget berdasarkan dua komponen utama, yaitu crawl capacity limit dan crawl demand.
Keduanya bekerja bersama untuk menentukan seberapa banyak URL yang dapat dan perlu dikunjungi Googlebot.
1. Crawl Capacity Limit
Crawl capacity limit adalah batas kapasitas crawling yang ditentukan dengan mempertimbangkan kemampuan server website.
Googlebot perlu mengunjungi halaman tanpa membebani server. Jika server merespons dengan cepat dan stabil, kapasitas crawling dapat meningkat secara otomatis.
Sebaliknya, jika website sering mengalami server error, waktu respons lambat, atau pembatasan akses, Googlebot dapat mengurangi aktivitas crawling untuk menjaga stabilitas server.
2. Crawl Demand
Crawl demand adalah tingkat kebutuhan Google untuk mengunjungi kembali halaman sebuah website.
Google mempertimbangkan beberapa hal, seperti popularitas URL, frekuensi pembaruan konten, serta jumlah dan kualitas halaman yang diketahui.
Sebagai contoh, halaman berita yang sering diperbarui mungkin perlu di-crawl lebih sering dibandingkan halaman profil perusahaan yang jarang mengalami perubahan.
Kedua komponen tersebut menentukan crawl budget. Jadi, meskipun server memiliki kapasitas yang besar, Google belum tentu akan melakukan crawling lebih banyak jika tidak ada kebutuhan untuk mengunjungi URL tambahan.
Faktor yang Memengaruhi Crawl Budget
Ada beberapa aspek yang dapat memengaruhi aktivitas crawling Googlebot. Berikut ringkasan faktor yang perlu kamu perhatikan.
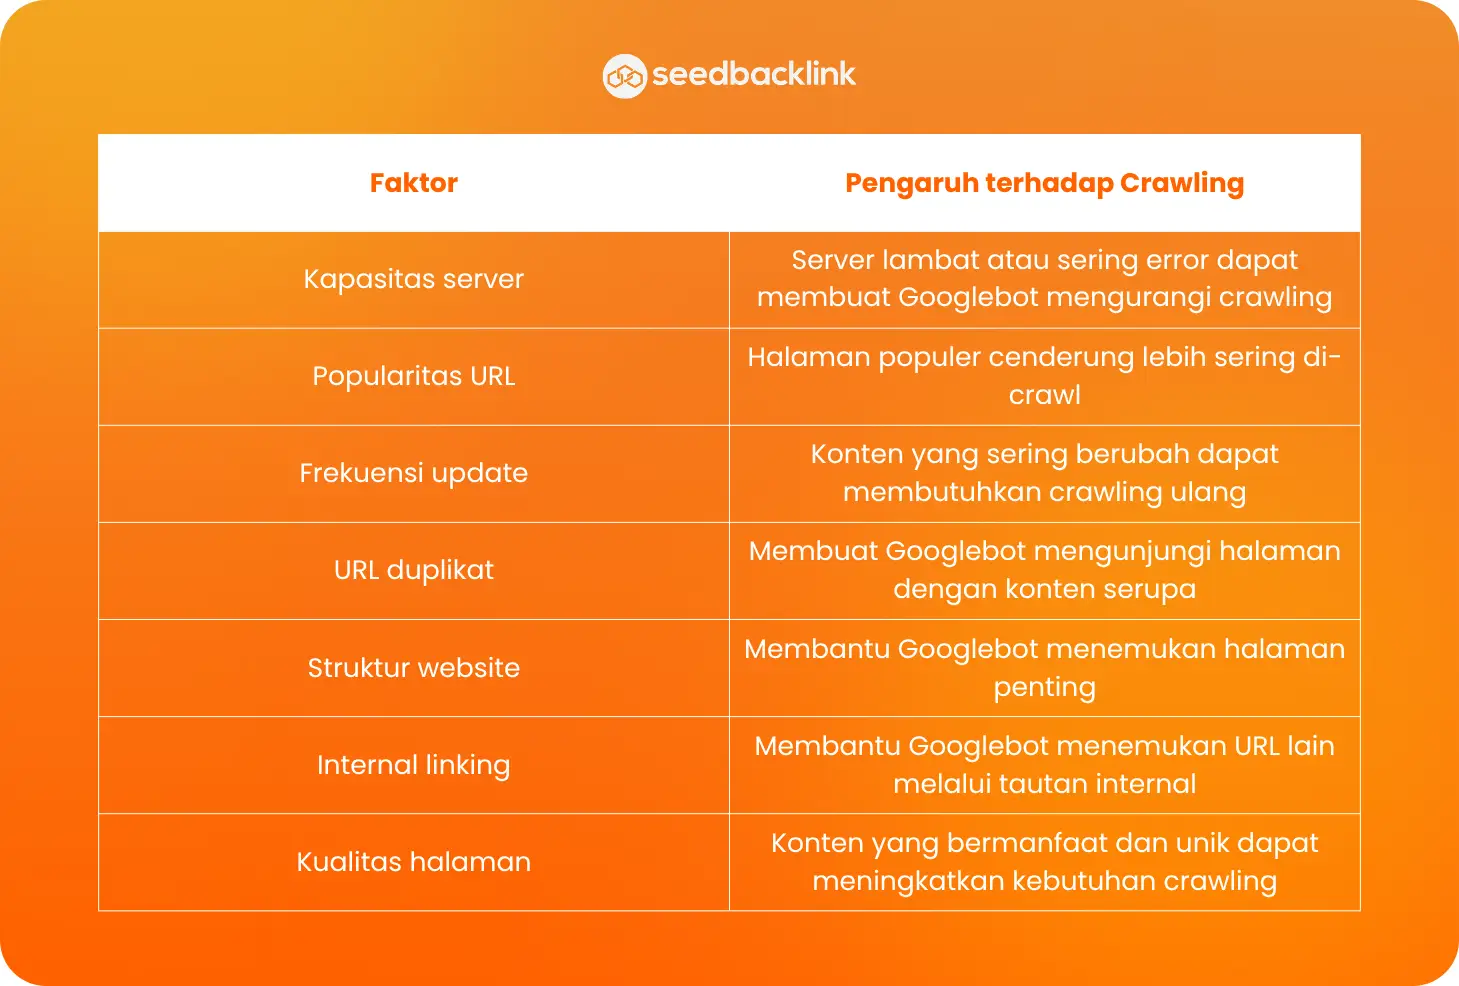
Perlu diingat, tidak semua faktor tersebut secara langsung meningkatkan crawl budget. Beberapa di antaranya lebih berperan dalam membantu Google menemukan URL atau menjaga efisiensi proses crawling.
5 Cara Mengoptimalkan Crawl Budget
Optimasi crawl budget bukan sekadar membuat Googlebot mengunjungi lebih banyak halaman. Fokus utamanya adalah memastikan Google menghabiskan resource crawling pada URL yang memang penting bagi website.
Berikut beberapa strategi yang bisa kamu terapkan.
1. Kelola URL yang Tidak Diperlukan
Periksa apakah website menghasilkan URL tambahan dari filter produk, fitur sorting, parameter tracking, atau session ID.
Jika URL tersebut tidak memberikan konten yang berbeda dan tidak perlu muncul di hasil pencarian, pertimbangkan cara pengelolaannya.
Kamu dapat menggabungkan halaman duplikat menggunakan canonical, menghapus URL yang sudah tidak diperlukan, atau mengatur crawling melalui robots.txt sesuai kebutuhan.
Pastikan setiap tindakan sesuai dengan fungsi URL. Jangan sampai halaman penting justru ikut diblokir.
2. Perbarui XML Sitemap
XML sitemap membantu Google menemukan URL penting di website kamu.
Pastikan sitemap hanya berisi URL yang ingin di-crawl dan berpotensi diindeks. Hindari memasukkan halaman yang sudah dihapus, URL redirect, atau halaman yang diblokir dari crawling.
Kamu juga dapat menggunakan atribut lastmod untuk memberikan informasi mengenai waktu terakhir halaman diperbarui, selama tanggal tersebut benar-benar mencerminkan perubahan konten.
Setelah diperbarui, sitemap dapat dikirim melalui Google Search Console.
3. Perbaiki Internal Linking
Internal linking membantu Googlebot menemukan halaman lain melalui tautan yang tersedia di website.
Hubungkan artikel, halaman kategori, dan halaman produk yang memiliki hubungan topik. Pastikan halaman penting tidak terlalu jauh dari struktur navigasi utama.
Selain membantu crawling, internal linking juga memberikan konteks hubungan antarkonten kepada mesin pencari dan memudahkan pengunjung menjelajahi website.
4. Atur Robots.txt dengan Tepat
File robots.txt digunakan untuk memberikan instruksi kepada crawler mengenai URL atau direktori yang boleh dan tidak boleh di-crawl.
Kamu dapat menggunakannya untuk membatasi crawling pada URL yang tidak diperlukan, seperti halaman hasil filter tertentu atau area website yang tidak ditujukan untuk crawling.
Namun, jangan sembarangan memblokir URL. Jika halaman diblokir melalui robots.txt, Googlebot tidak dapat membaca kontennya, termasuk instruksi noindex yang mungkin terdapat di dalam halaman tersebut.
Jika tujuanmu adalah mencegah halaman muncul di hasil pencarian, gunakan metode yang sesuai dengan kebutuhan indexing, bukan sekadar memblokir crawling.
5. Tingkatkan Performa Server dan Website
Performa server berpengaruh terhadap kemampuan Googlebot melakukan crawling.
Jika server sering lambat atau mengembalikan error, Google dapat mengurangi frekuensi permintaan crawling untuk menjaga stabilitas website.
Beberapa hal yang bisa kamu lakukan antara lain:
-
Mengoptimalkan ukuran gambar dan resource website.
-
Menggunakan caching untuk mengurangi permintaan berulang.
-
Memperbaiki response time server.
-
Mengurangi redirect chain yang terlalu panjang.
-
Memperbaiki error server seperti HTTP 5xx dan pembatasan akses HTTP 429.
Dengan server yang lebih stabil, Googlebot dapat mengakses halaman secara lebih efisien.
Cara Memantau Crawl Budget melalui Google Search Console
Setelah melakukan optimasi, kamu perlu memantau aktivitas crawling untuk mengetahui apakah Googlebot dapat mengakses website dengan baik.
Salah satu alat yang bisa digunakan adalah Google Search Console. Berikut beberapa fitur yang dapat membantu.
1. Crawl Stats Report
Crawl Stats Report memberikan gambaran aktivitas Googlebot saat mengunjungi website.
Kamu dapat memeriksa jumlah permintaan crawling, waktu respons server, ukuran file yang diunduh, serta respons HTTP yang diterima Googlebot.
Data tersebut membantu kamu mengidentifikasi apakah terdapat masalah server yang menghambat proses crawling.
2. Page Indexing Report
Page Indexing Report membantu kamu melihat status halaman yang diketahui Google.
Melalui report ini, kamu dapat memeriksa halaman yang sudah diindeks maupun URL yang belum masuk ke indeks Google. Perhatikan status seperti Discovered - currently not indexed dan Crawled - currently not indexed untuk memahami kendala yang mungkin terjadi.
Perlu diingat, status tersebut tidak selalu menunjukkan masalah crawl budget. Penyebabnya bisa berkaitan dengan kualitas konten, duplikasi, atau proses evaluasi indexing.
3. URL Inspection Tool
Fitur ini memungkinkan kamu memeriksa status sebuah URL secara lebih spesifik.
Kamu dapat mengetahui apakah Google sudah menemukan dan meng-crawl halaman, kapan terakhir kali halaman di-crawl, serta apakah URL tersebut dapat diindeks.
Jika halaman penting belum ditemukan atau mengalami masalah crawling, gunakan informasi tersebut untuk menentukan langkah perbaikan.
Apakah Semua Website Perlu Mengoptimalkan Crawl Budget?
Tidak semua website perlu melakukan optimasi crawl budget secara mendalam.
Google menjelaskan bahwa pengelolaan crawl budget terutama ditujukan untuk website besar dengan lebih dari satu juta halaman unik yang kontennya cukup sering berubah, atau website dengan lebih dari 10.000 halaman unik yang mengalami pembaruan sangat cepat.
Website dengan jumlah halaman lebih kecil umumnya tidak perlu melakukan optimasi teknis yang terlalu kompleks. Memastikan sitemap selalu diperbarui, struktur website mudah dijelajahi, dan tidak ada halaman penting yang terblokir biasanya sudah menjadi langkah awal yang memadai.
Jadi, sebelum melakukan perubahan pada robots.txt atau mengatur URL secara masif, periksa terlebih dahulu apakah website memang mengalami kendala crawling.
Optimalkan Crawl Budget untuk Mendukung Performa SEO
Crawl budget merupakan salah satu aspek teknis yang membantu Googlebot mengunjungi URL secara efisien. Pengelolaannya menjadi semakin penting ketika website memiliki banyak halaman atau konten yang sering diperbarui.
Kamu bisa memulainya dengan mengelola URL duplikat, memperbarui XML sitemap, memperbaiki internal linking, mengatur robots.txt, dan menjaga performa server.
Namun, crawl budget bukan satu-satunya faktor yang menentukan performa SEO. Konten yang relevan, pengalaman pengguna, struktur website, dan kualitas backlink tetap perlu diperhatikan sebagai bagian dari strategi SEO secara menyeluruh.
Jika kamu ingin memperkuat domain authority website melalui strategi link building, seedbacklink dapat membantu menghubungkan brand dengan media dan blogger yang relevan. Kamu bisa menjelajahi layanan jasa backlink, backlink media nasional, dan backlink blog dari seedbacklink untuk mendukung visibilitas website di mesin pencari.